전화용 AI 모델 고르는 기준: 벤치마크보다 중요한 일곱 가지
전화 상담용 AI 모델은 범용 벤치마크 점수보다 첫 응답 속도, 짧은 답 생성, 도구 호출 안정성, 지시 준수, 한국어 구어 이해, 데이터 처리 위치, 교체 용이성으로 고르는 편이 정확합니다. 기준별 시험 방법과 평가표를 정리했습니다.
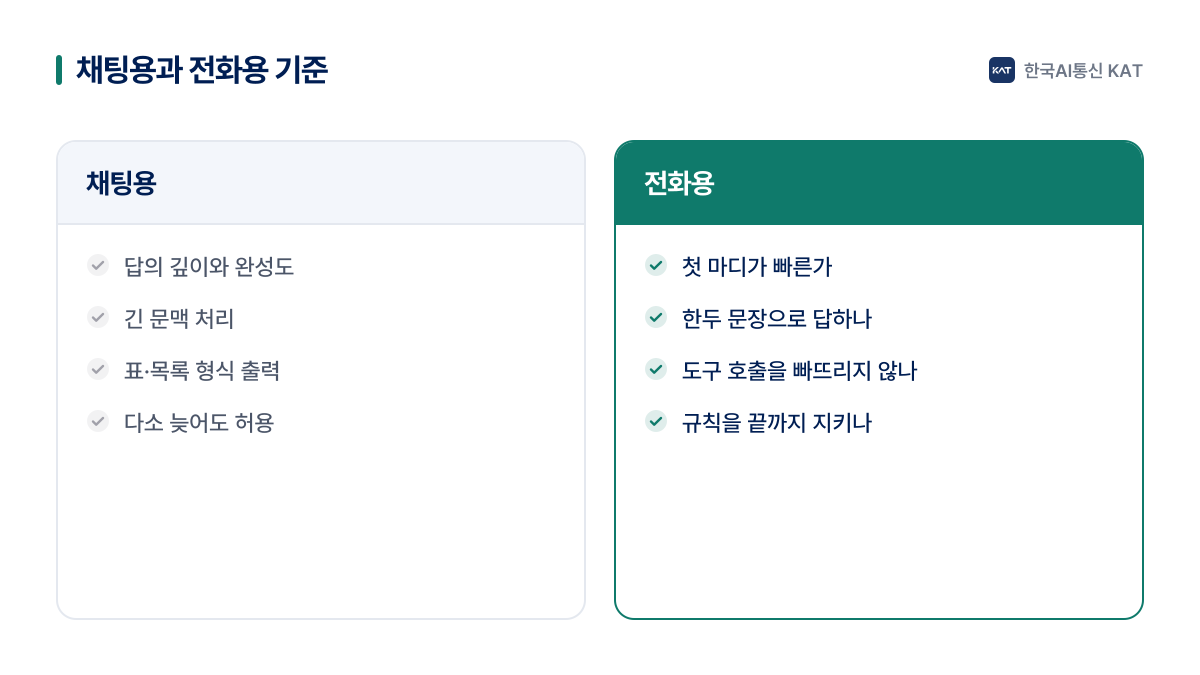
전화용 AI 모델은 "가장 똑똑한 모델"이 아니라 "전화 한 통 안에서 가장 덜 실수하는 모델"을 골라야 합니다. 범용 벤치마크 점수가 높은 모델도 첫 마디가 늦거나, 답이 길거나, 도구 호출을 가끔 빠뜨리면 전화에서는 쓰기 어렵습니다. 실무에서는 첫 응답 속도, 짧고 구어적인 답, 도구 호출 안정성, 지시문 준수, 한국어 구어 이해, 데이터 처리 위치, 교체 용이성의 일곱 가지로 비교하는 편이 정확합니다. 이 글은 전화망 위에서 보이스 AI를 운영하는 한국AI통신이 모델 선택 기준과 시험 방법을 정리한 것입니다. 특정 모델의 순위는 빠르게 바뀌므로 다루지 않습니다.
왜 전화는 기준이 다른가
채팅에서는 답이 조금 늦거나 길어도 사용자가 화면을 보며 기다립니다. 전화에서는 고객이 말을 끝낸 뒤의 침묵이 곧 불안이고, 긴 답은 끝까지 듣지 않습니다. 또 전화 AI는 예약 조회, 접수 저장 같은 도구 호출을 대화 중에 실시간으로 해야 하고, 실패하면 되돌리기 어렵습니다. 그래서 모델의 "지능"보다 반응성, 절제, 일관성이 중요해집니다.
일곱 가지 기준
| 기준 | 왜 중요한가 | 시험 방법 |
|---|---|---|
| 첫 응답 속도 | 첫 토큰이 늦으면 침묵이 길어짐 | 같은 경로에서 첫 토큰 시간 반복 측정 |
| 짧은 답 생성 | 전화는 한 번에 한 가지만 전달 | 지시문에 길이 제한을 두고 지키는지 확인 |
| 도구 호출 안정성 | 예약·조회 누락은 업무 실패 | 같은 시나리오 반복 시 호출 누락·형식 오류 |
| 지시문 준수 | 고지 문구, 금지 안내 지키기 | 유도 질문으로 규칙 위반 시도 |
| 한국어 구어 이해 | 인식 오류가 섞인 문장 처리 | 실제 전사 텍스트로 의도 파악 시험 |
| 데이터 처리 위치 | 개인정보, 국외 이전 | 제공사 정책과 계약 조건 확인 |
| 교체 용이성 | 모델은 계속 바뀜 | 지시문·도구 정의를 모델 독립적으로 유지 |
기준별로 더 들여다보기
첫 응답 속도: 평균보다 꼬리를 보라
평균 응답 시간이 빨라도 가끔 크게 늦어지는 모델은 전화에서 문제입니다. 고객은 평균이 아니라 가장 길었던 침묵을 기억합니다. 시험할 때는 평균과 함께 느린 쪽 꼬리를 보세요. 전체 지연 구조는 AI 전화 응답 지연은 어디서 생기나에서 다룹니다.
실시간 음성 모델이라면 기준이 조금 바뀐다
음성을 바로 듣고 말하는 실시간 음성 모델은 언어 모델과 음성 처리가 하나로 묶여 있어, 위 표의 "첫 응답 속도"와 "한국어 구어 이해"를 모델 단위로 평가하게 됩니다. 대신 지시문 준수와 문구 통제는 텍스트를 거치는 구조보다 시험을 더 촘촘히 해야 합니다. 구조 비교는 실시간 음성 모델 vs 캐스케이드 구조 비교를 참고하세요.
도구 호출: 한 번의 누락이 업무 실패
전화 AI가 "예약해 드렸습니다"라고 말했는데 실제로 예약 도구를 호출하지 않았다면 가장 나쁜 실패입니다. 같은 시나리오를 여러 번 돌려 호출 누락, 잘못된 인자, 호출 전에 완료를 말하는 경우를 세어 보세요. 설계 방법은 보이스 에이전트의 도구 호출에서 다룹니다.
데이터 처리 위치
전화 대화에는 이름, 연락처, 예약 정보가 담깁니다. 모델 제공사가 어느 지역에서 처리하는지, 입력 데이터를 학습에 쓰는지, 보관 기간은 어떤지 확인하고 개인정보 처리방침에 반영해야 합니다. 한국AI통신도 음성 인식과 언어 모델은 계약을 맺은 클라우드 AI 사업자의 것을 쓰며 국외 이전이 포함된다는 사실을 보안·신뢰 페이지에 공개하고 있습니다.
실전 평가 절차
- 1실제 통화 기록(또는 그와 비슷한 예시)에서 대표 시나리오를 열 개 안팎으로 고릅니다. 예약, 변경, 취소, 영업시간 문의, 사람 연결 요청, 엉뚱한 질문을 섞습니다.
- 2같은 지시문과 도구 정의로 후보 모델마다 여러 번 돌립니다.
- 3업무 완료, 잘못된 안내, 도구 호출 오류, 답 길이, 첫 응답 시간을 기록합니다.
- 4상위 후보는 실제 휴대폰으로 시험 통화를 겁니다. 텍스트 시험과 전화 체감은 다를 수 있습니다.
- 5지시문과 도구 정의를 특정 모델 문법에 묶지 않고 관리해, 나중에 교체할 수 있게 합니다.
평가 지표 설계는 보이스 에이전트 품질은 어떻게 평가하나에서 자세히 다룹니다.
모델을 바꿀 수 있는 구조가 답이다
전화 AI에 맞는 모델은 몇 달 사이에도 바뀝니다. 그래서 가장 중요한 결정은 특정 모델을 고르는 것보다 모델을 바꿀 수 있는 구조를 갖추는 것입니다. 번호와 회선은 통신 인프라에, 지시문과 도구는 우리 쪽에 두고, 음성 처리와 모델은 교체 가능한 부품으로 다루면 됩니다. 한국에이아이통신(주)가 운영하는 한국AI통신의 KAT Cloud는 실시간 음성 AI 연결과 SIP 연결을 함께 제공해 모델이나 음성 서버를 바꿔도 같은 번호를 유지할 수 있습니다.
자주 묻는 질문
전화 AI에는 가장 성능 좋은 대형 모델을 쓰면 되나요?
전화 AI에는 범용 성능이 가장 높은 모델이 꼭 최선은 아닙니다. 전화에서는 첫 응답 속도, 짧은 답, 도구 호출 안정성, 지시문 준수가 더 중요하므로, 실제 업무 시나리오와 시험 통화로 후보 모델을 비교해 고르는 것이 정확합니다.
전화용 AI 모델을 시험할 때 무엇을 측정해야 하나요?
전화용 AI 모델 시험에서는 업무 완료 여부, 잘못된 안내, 도구 호출 누락과 형식 오류, 답 길이, 첫 응답 시간을 측정합니다. 첫 응답 시간은 평균뿐 아니라 가끔 크게 늦어지는 경우까지 함께 보는 것이 좋습니다.
모델을 나중에 바꾸려면 무엇을 준비해야 하나요?
모델을 나중에 바꾸려면 지시문과 도구 정의를 특정 모델의 문법에 묶지 않고 관리하고, 전화번호와 회선은 통신 인프라에 따로 두는 것이 좋습니다. 그러면 모델이나 음성 서버를 교체해도 번호와 업무 연동은 그대로 유지됩니다.
- #LLM 선택
- #전화 AI
- #보이스 에이전트
- #모델 평가
- #실시간 음성